ภูมิทัศน์ของ AI ได้เปลี่ยนไปอย่างมากด้วยการเกิดขึ้นของโมเดลภาษาขนาดใหญ่ (LLMs) ซึ่งยืนอยู่แถวหน้าของความก้าวหน้าในการประมวลผลภาษาธรรมชาติ (NLP) ในปัจจุบัน โมเดลที่ซับซ้อนเหล่านี้มีความเชี่ยวชาญในการสร้างข้อความที่คล้ายคลึงกับการเขียนของมนุษย์อย่างน่าทึ่ง ครอบคลุมหลากหลายสาขา มีความเคลื่อนไหวที่เพิ่มขึ้นในการปรับแต่ง LLM ให้เหมาะสมกับอุตสาหกรรมเฉพาะด้าน เช่น แชตบอตที่ออกแบบมาโดยเฉพาะสำหรับผู้เชี่ยวชาญด้านกฎหมาย หรือผู้เชี่ยวชาญด้านการดูแลสุขภาพ
ในบล็อกนี้ ผมจะนำทางคุณไปสู่ประโยชน์ที่สำคัญของ LLM เฉพาะโดเมน เราจะสำรวจกลยุทธ์สำคัญสามประการในการปรับแต่งโมเดลเหล่านี้ ได้แก่: prompt engineering, retrieval augmented generation (RAG) และ fine-tuning เพื่อให้แนวคิดเหล่านี้จับต้องได้มากขึ้น ผมจะขอแนะนำแนวทางที่ผมชอบเรียกว่า "การเปรียบเทียบกับนักเรียน" มาเริ่มต้นกันเลย!
ประโยชน์หลักของ LLM ที่ปรับแต่งเฉพาะ
การปรับแต่ง LLM ให้เข้ากับโดเมนเฉพาะของคุณมีประโยชน์ดังต่อไปนี้:
ความแม่นยำและข้อมูลเชิงลึก: ด้วยการมุ่งเน้นไปที่ชุดข้อมูลเฉพาะสำหรับบางสาขา เช่น กฎหมายหรือการดูแลสุขภาพ LLM ไม่เพียงแต่จะบรรลุความถูกต้องแม่นยำที่สูงขึ้นเท่านั้น แต่ยังมีความเข้าใจอย่างลึกซึ้งเกี่ยวกับความแตกต่างเฉพาะของอุตสาหกรรมด้วย ซึ่งทำงานได้ดีกว่าโมเดลทั่วไปในด้านความเกี่ยวข้องและรายละเอียด
ความสม่ำเสมอและความน่าเชื่อถือ: การมุ่งเน้นไปที่สาขาใดสาขาหนึ่งโดยเฉพาะจะช่วยลดโอกาสที่โมเดลจะเข้าถึงข้อมูลที่ไม่เกี่ยวข้อง ส่งผลให้ผลลัพธ์ที่ได้มีความสม่ำเสมอและน่าเชื่อถือมากขึ้น
การบรรเทาความเสี่ยง: ในโดเมนที่มีความเสี่ยงสูงอย่างการดูแลสุขภาพและกฎหมาย ความไม่ถูกต้องอาจส่งผลร้ายแรงตามมาได้ LLM เฉพาะโดเมนที่ได้รับการเสริมประสิทธิภาพด้วยคุณลักษณะด้านความปลอดภัยพิเศษ จะช่วยให้ข้อมูลเชิงลึกที่ปลอดภัยและเชื่อถือได้มากกว่า
การโต้ตอบที่ดียิ่งขึ้น: การเชื่อมต่อกับ LLM ที่เข้าใจและใช้คำศัพท์และบริบทเฉพาะของโดเมนนั้น ๆ จะช่วยให้ผู้ใช้ได้รับประสบการณ์ที่พึงพอใจและมีประสิทธิภาพมากขึ้น
ประสิทธิภาพในการดำเนินงาน: บ่อยครั้งการปรับจูน (fine-tune) โมเดลเฉพาะโดเมนที่มีขนาดเล็กกว่า จะมีประสิทธิภาพในด้านทรัพยากรมากกว่าการใช้งานโมเดลอเนกประสงค์ขนาดใหญ่ โมเดลเฉพาะทางเหล่านี้สามารถส่งมอบผลลัพธ์ที่เหนือกว่าได้ด้วยต้นทุนที่คุ้มค่ากว่า
สรุปแล้ว แม้ว่า LLM อเนกประสงค์ทั่วไปจะสามารถจัดการกับงานที่หลากหลายได้ แต่ LLM ที่ปรับแต่งเฉพาะโดเมนนั้นถูกสร้างขึ้นมาเพื่อให้ตรงกับความต้องการและความซับซ้อนเฉพาะของแต่ละสาขา ส่งผลให้ผลลัพธ์ที่ได้มีความแม่นยำ น่าเชื่อถือ และมีประสิทธิภาพมากขึ้น ทำหน้าที่เป็นตัวเชื่อมสำคัญระหว่างความรู้ทั่วไปและความเชี่ยวชาญเฉพาะด้าน ซึ่งช่วยเพิ่มประสิทธิภาพโดยรวมและความเกี่ยวข้องของโมเดล
การปรับแต่ง LLM เพื่อความแม่นยำของโดเมน
หลังจากที่เน้นย้ำถึงความสำคัญของ LLM เฉพาะโดเมนแล้ว ตอนนี้เรามาสำรวจคู่มือสามขั้นตอนที่ครอบคลุมเพื่อสร้าง LLM เฉพาะทางกัน ส่วนถัดไปจะเจาะลึกเข้าไปในเทคนิคเหล่านี้ โดยจะอธิบายรายละเอียดของแต่ละขั้นตอนอย่างเจาะลึก
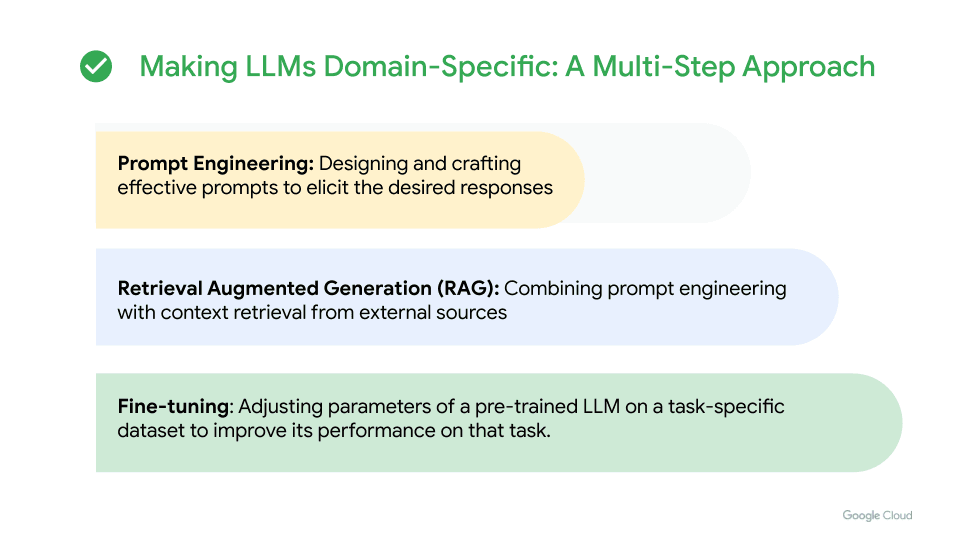
Prompt engineering, RAG และ fine-tuning สามารถนำเสนอแนวทางสามขั้นตอนสำหรับการสร้าง LLM เฉพาะโดเมนได้
ขั้นตอนที่ 1: Prompt engineering
การใช้ prompt engineering เป็นวิธีที่รวดเร็วในการดึงข้อมูลเชิงลึกเฉพาะโดเมนจาก LLM ทั่วไป โดยไม่ต้องเปลี่ยนโครงสร้างหรือต้องฝึกอบรมโมเดลใหม่ เทคนิคนี้เกี่ยวข้องกับการกำหนดคำถามหรือข้อความสั่ง (prompt) ที่ตรงเป้าหมาย เพื่อนำทางโมเดลในการสร้างผลลัพธ์ที่ปรับให้เหมาะกับโดเมนเฉพาะ ตัวอย่างเช่น การสั่งให้โมเดลทั่วไป "ให้คำตอบที่กระชับโดยใช้คำศัพท์ทางการแพทย์เสมอ" จะกระตุ้นให้โมเดลตอบกลับแบบสั้น ๆ และเน้นไปที่ทางการแพทย์ สำหรับคำแนะนำเพิ่มเติมเกี่ยวกับการสร้าง prompt ที่มีประสิทธิภาพ โปรดดูคู่มือเอกสารประกอบ “Introduction to prompt design” สำหรับข้อมูลเชิงลึกเกี่ยวกับการกระตุ้นให้ได้คำตอบที่ต้องการจากโมเดลภาษาที่มีให้บริการผ่าน Vertex AI บน Google Cloud
ขั้นตอนที่ 2: RAG (retrieval augmented generation)
RAG ใช้ประโยชน์จากพลังของการรวมการดึงข้อมูลเข้ากับ LLM ด้วยการเชื่อมโยงไปยังแหล่งความรู้ภายนอก เช่น ฐานข้อมูลเอกสาร LLM จะสามารถเข้าถึงข้อมูลที่เกี่ยวข้องเพื่อสร้างคำตอบได้ ฟังก์ชันนี้มีความสำคัญอย่างยิ่งต่อการส่งมอบคำตอบที่โปร่งใสและแม่นยำ ช่วยให้โมเดลสามารถดึงข้อมูลแบบเรียลไทม์หรือข้อมูลเฉพาะทางที่อาจจะอยู่นอกเหนือชุดข้อมูลการฝึกอบรมเริ่มต้นได้ ตัวอย่างเช่น เมื่อออกแบบแชตบอตทางการแพทย์ RAG จะช่วยให้ LLM สามารถเข้าถึงคลังข้อมูลวรรณกรรมทางการแพทย์ในปัจจุบัน เอกสารการวิจัย และแนวทางปฏิบัติทางคลินิกได้ ดังนั้น เมื่อผู้ใช้ค้นหาข้อมูลเกี่ยวกับการรักษาล่าสุดสำหรับสภาวะเฉพาะ LLM จะสามารถดึงข้อมูลล่าสุดจากฐานข้อมูลนี้เพื่อเสนอคำตอบที่ครอบคลุมและมีรากฐานมาจากความก้าวหน้าทางการแพทย์ล่าสุด
Vertex AI Search ของ Google มอบไปป์ไลน์การค้นหาแบบ RAG ที่สมบูรณ์แบบ ช่วยให้ผู้ใช้สามารถสร้างประสบการณ์การค้นหาที่ขับเคลื่อนด้วย AI สำหรับแพลตฟอร์มทั้งภายในและภายนอก นอกจากนี้ Vertex AI Vector Search ซึ่งก่อนหน้านี้รู้จักกันในชื่อ Vertex AI Matching Engine ยังมอบฐานข้อมูลเวกเตอร์ที่ผสานรวมกับ LLM ของคุณได้อย่างราบรื่น ช่วยอำนวยความสะดวกในการพัฒนาแชตบอตตอบคำถามที่ขับเคลื่อนด้วย RAG ดังที่อธิบายไว้ในบทความนี้
สิ่งสำคัญที่ต้องบันทึกไว้คือ แม้ว่าการสร้างต้นแบบ RAG อาจดูเหมือนตรงไปตรงมา แต่การสร้างระบบ RAG ในระดับใช้งานจริง (production-level) นั้นมีความซับซ้อนอย่างมาก กระบวนการนี้มักต้องการการปรับปรุงคุณภาพอย่างต่อเนื่อง และจำเป็นต้องทำการตัดสินใจด้านการออกแบบที่ซับซ้อน เช่น การเลือก embeddings ที่เหมาะสม การกำหนดฐานข้อมูลเวกเตอร์ที่เหมาะสมที่สุด และการระบุอัลกอริทึมการแบ่งกลุ่มข้อมูล (chunking) ที่มีประสิทธิภาพที่สุด
สำหรับผู้ที่ต้องการทำความเข้าใจเทคโนโลยี RAG ให้ลึกซึ้งยิ่งขึ้น ผมแนะนำให้เจาะลึกข้อมูลเชิงลึกที่แบ่งปันในบทความ Medium ที่ชื่อว่า "Advanced RAG Techniques: an Illustrated Overview" และสำรวจรายละเอียดที่มีการพูดคุยกันในโพสต์บล็อก Google Cloud นี้ "Your RAGs powered by Google Search technology" แหล่งข้อมูลเหล่านี้จะช่วยให้เข้าใจถึงความซับซ้อนและการตัดสินใจในการออกแบบที่สำคัญซึ่งจำเป็นสำหรับการพัฒนาระบบ RAG ขั้นสูง
ขั้นตอนที่ 3: Fine-tuning
การปรับเปลี่ยน pre-trained LLM เช่น PaLM 2 for Text (text-bison) บน Vertex AI ให้มีความเชี่ยวชาญเฉพาะด้านนั้น จะเกี่ยวข้องกับการปรับจูน (fine-tuning) โมเดลด้วยชุดข้อมูลเฉพาะโดเมนที่มีขนาดเล็กกว่า กระบวนการนี้จะช่วยเพิ่มความเชี่ยวชาญของโมเดลในด้านเฉพาะนั้น ๆ เช่น การปรับปรุงความเข้าใจในหัวข้อทางการแพทย์เมื่อติดตั้ง RAG สำหรับความรู้ทางการแพทย์ ด้วยการรวมข้อมูลเชิงลึกทางการแพทย์ที่เกี่ยวข้องจาก RAG และการปรับปรุงคำตอบด้วยคำศัพท์และสำนวนที่เหมาะสมผ่านการ fine-tuning โมเดลจะสามารถส่งมอบคำตอบที่แม่นยำและให้ข้อมูลได้ดีขึ้น
สำหรับคำแนะนำเพิ่มเติมเกี่ยวกับการปรับแต่งโมเดลภาษาพื้นฐานบน Vertex AI โปรดอ้างอิงแหล่งข้อมูลที่จัดเตรียมไว้ให้เพื่อดูคำแนะนำโดยละเอียด โปรดจำไว้ว่า แม้ว่าลำดับขั้นตอนที่แนะนำของแนวทางเหล่านี้จะนำเสนอวิธีการที่เป็นระบบในการปรับแต่ง LLM แต่คุณก็สามารถปรับเปลี่ยนและผสมผสานเทคนิคเหล่านี้ได้ตามความต้องการของโครงการของคุณ แต่ละวิธีสามารถนำไปใช้ได้อย่างเป็นอิสระหรือร่วมกับวิธีอื่น ๆ ซึ่งช่วยให้มีความยืดหยุ่นในการปรับปรุงประสิทธิภาพของโมเดลให้เหมาะสมที่สุด สำรวจส่วนถัดไปสำหรับการเปรียบเทียบเชิงลึกของกลยุทธ์เหล่านี้
เปรียบเทียบ prompt engineering, RAG และ fine-tuning
ด้านล่างนี้คือการเปรียบเทียบที่ครอบคลุมเพื่อแสดงให้เห็นถึงข้อดีที่แตกต่างกันของ prompt engineering, RAG และ fine-tuning ในบริบทของการปรับแต่งโมเดลภาษา
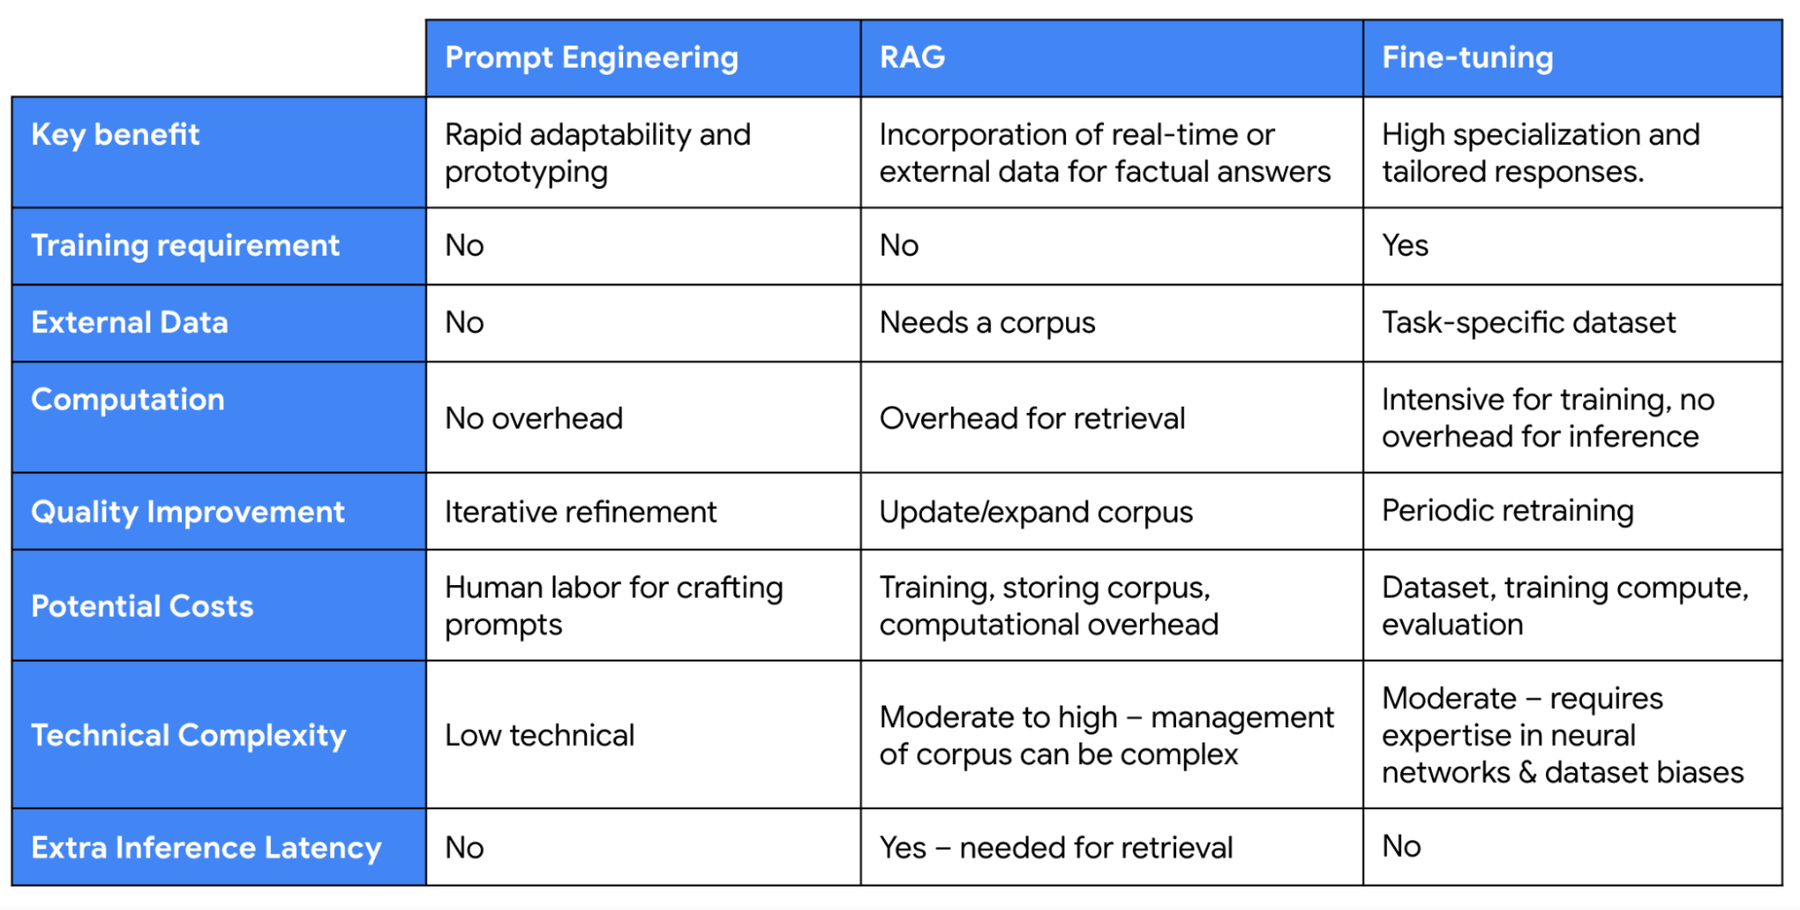
การเปรียบเทียบระหว่าง prompt engineering, RAG และ fine-tuning
ลองจินตนาการถึงแนวคิดของ prompt engineering, RAG และ fine-tuning เป็นการเดินทางของนักเรียนที่กระตือรือร้นที่จะเชี่ยวชาญภาษาใหม่ ภาพของ LLM ก็คือนักเรียนคนนั้น ที่เริ่มต้นจากศูนย์ในห้องสมุดขนาดใหญ่ที่มีแหล่งทรัพยากรทางภาษามากมาย การดื่มด่ำกับข้อมูลเหล่านี้ช่วยให้พวกเขาเข้าใจพื้นฐาน แต่อาจยังมีช่องว่างในความรู้เฉพาะทาง
เพื่อเชื่อมช่องว่างเหล่านี้ เราจึงนำเทคนิค prompt engineering, RAG และ fine-tuning เข้ามาช่วยเตรียมความพร้อมให้นักเรียนสำหรับความท้าทายเฉพาะโดเมน
Prompt engineering ทำหน้าที่เป็นแนวทาง โดยให้คำแนะนำสำหรับคำตอบที่ปรับแต่งเฉพาะ เปรียบเสมือนการให้นักเรียนทำตามบท เพื่อให้แน่ใจว่าคำตอบมีน้ำเสียงที่เป็นมืออาชีพในขณะที่ยังรักษาความรู้เดิมเอาไว้
RAG ในทางกลับกัน จะช่วยติดอาวุธให้นักเรียนด้วยตำราเรียนเฉพาะทางสำหรับการสอบแบบเปิดหนังสือ (open-book exam) สิ่งนี้ช่วยให้พวกเขาสามารถเข้าถึงข้อมูลแบบเรียลไทม์เพื่อปรับปรุงคำตอบของตนเอง เพื่อให้มั่นใจในความถูกต้องและความน่าเชื่อถือ
ในที่สุด fine-tuning จะเกี่ยวข้องกับการเจาะลึกเข้าไปในตำราเรียน เพื่อเตรียมความพร้อมของนักเรียนสำหรับการสอบแบบปิดหนังสือ (closed-book exam) ซึ่งพวกเขาต้องพึ่งพาเฉพาะความรู้ที่อยู่ในตัวเองเท่านั้น แม้ว่าวิธีนี้จะช่วยรับประกันคำตอบที่แม่นยำ แต่อาจมีข้อจำกัดในการอ้างอิงแหล่งที่มา
สำหรับการเริ่มต้นอย่างรวดเร็ว prompt engineering คือวิธีที่ตอบโจทย์ เมื่อคุณก้าวหน้าขึ้น ให้รวม RAG เข้ามาสำหรับการดึงข้อมูลแบบไดนามิก และเมื่อพร้อมแล้ว ให้ลงทุนกับการ fine-tuning ด้วยชุดข้อมูลที่หลากหลายเพื่อประสิทธิภาพสูงสุด
เริ่มต้นด้วยการพูดคุย 30 นาที
ปรึกษาขอบเขตงานฟรี 30 นาที
ผู้ที่คุยสายกับคุณคือวิศวกร ไม่ใช่ตัวแทนฝ่ายขาย
ตอบกลับเฉลี่ย: ต่ำกว่า 4 ชั่วโมง ในวันทำการ